AIには、軽いモデルと賢いモデルがあります。大事な仕事には、いちばん賢いものを選びがちです。けれども、賢いモデルは料金も高くなります。
当社は、もらったクレジット200ドル分で、Claude(クロード)の4つのモデルに同じ仕事をさせて比べました。この記事は、その結果です。
先に要点を3つ挙げます。
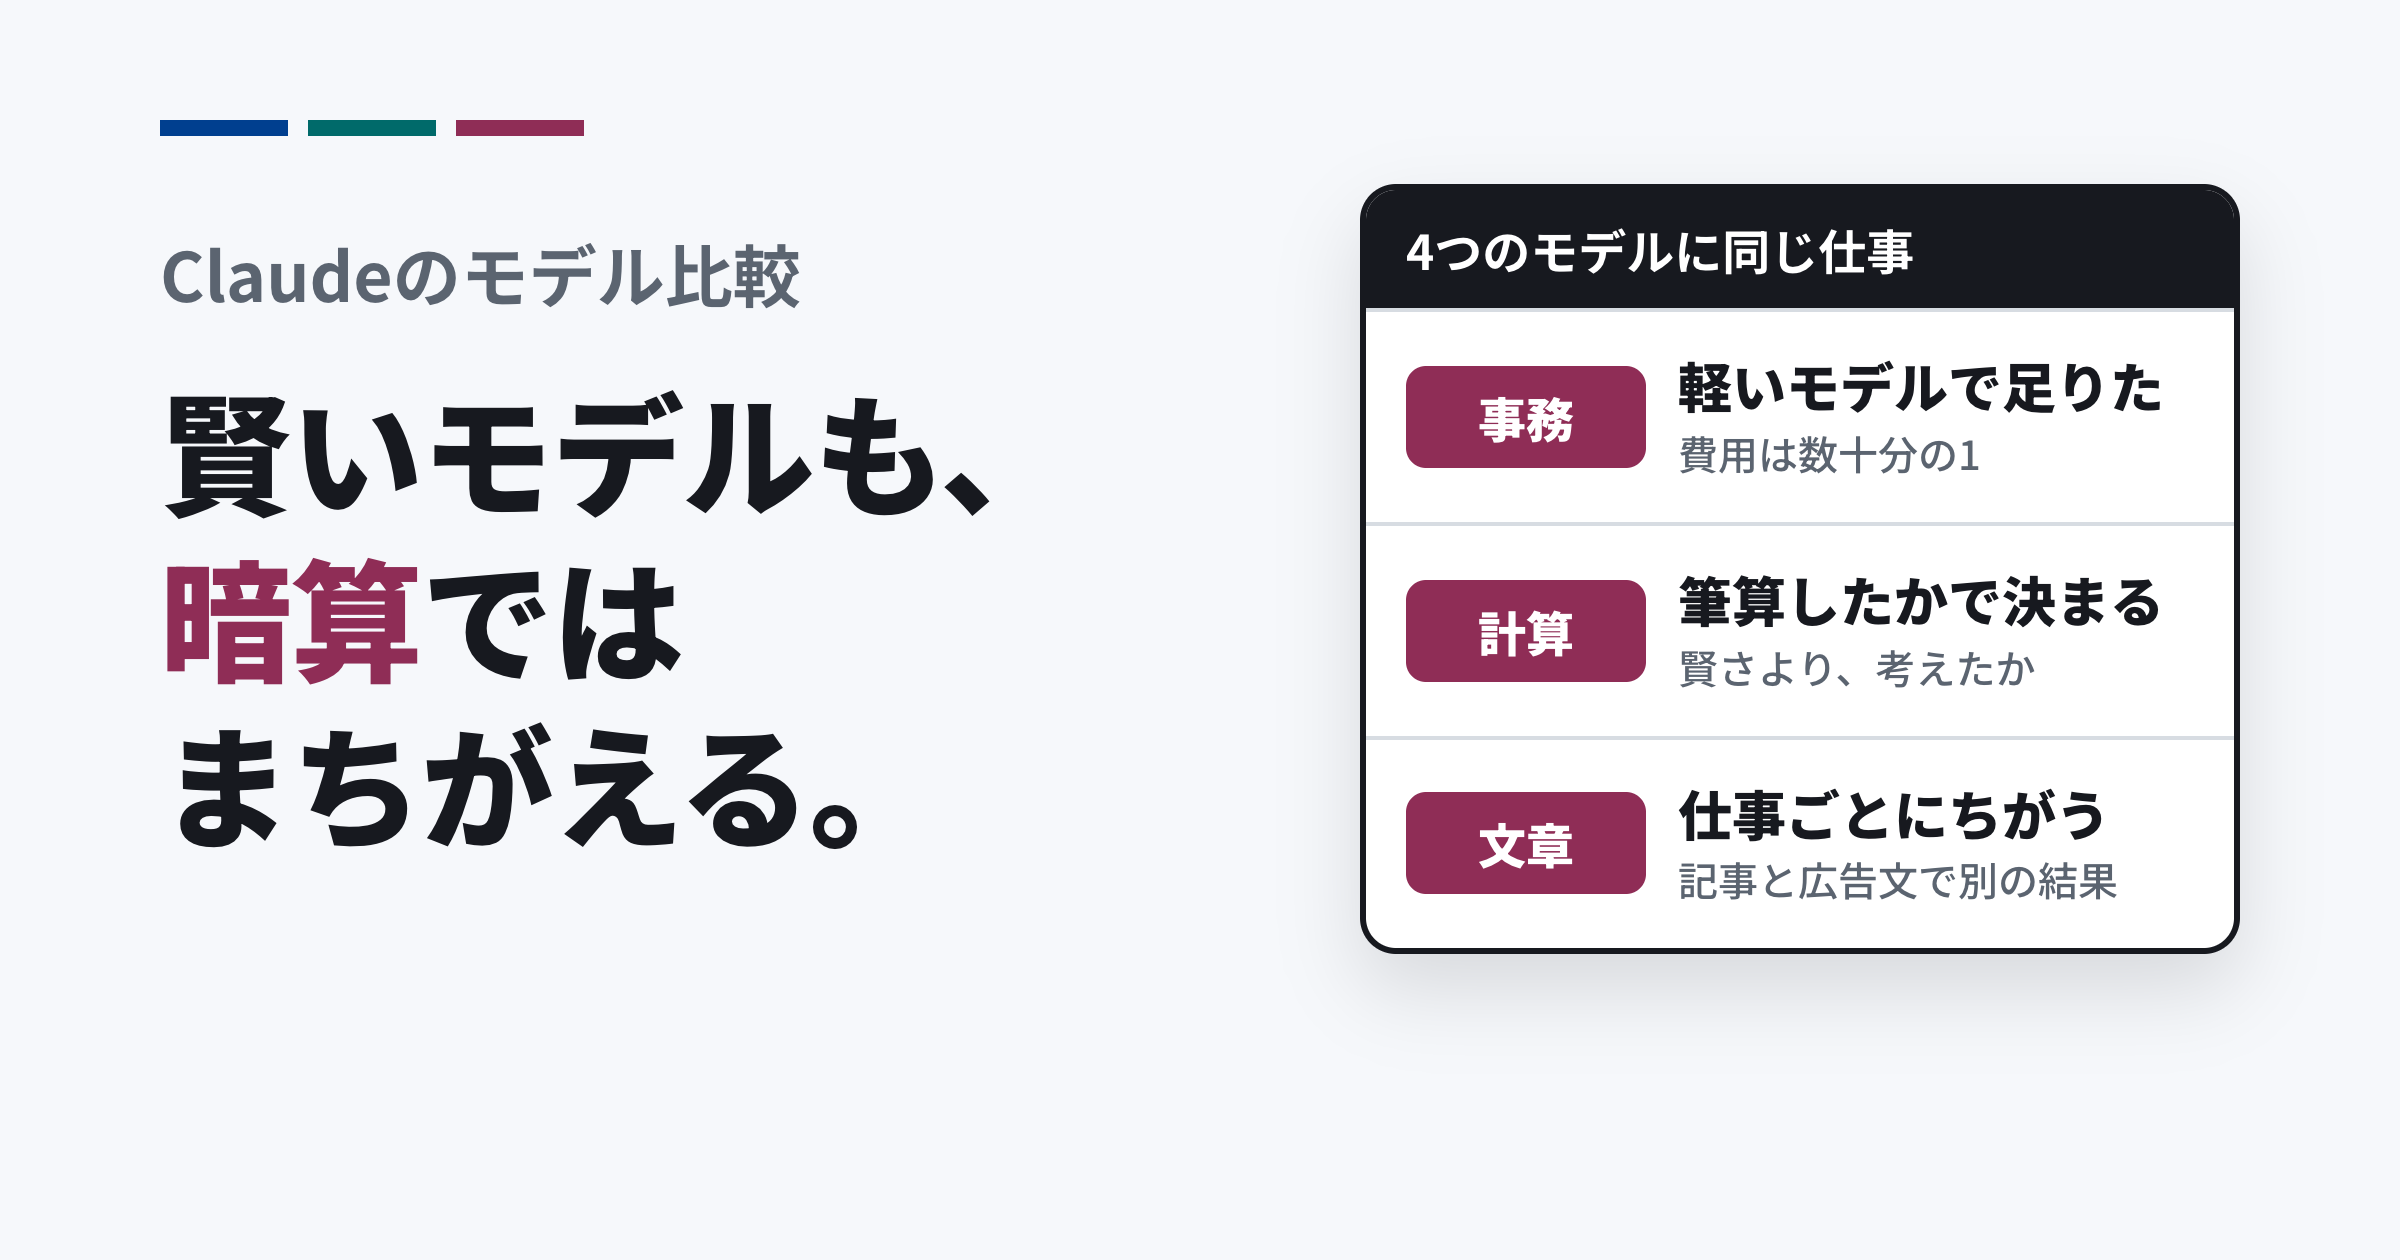
- 事務の仕事は、いちばん軽いモデルで足りました。 費用は、いちばん賢いモデルの数十分の1でした。
- 計算は、賢さより「筆算したか」で決まりました。 考えずに答えたモデルは、賢くても半分外しました。
- 文章は、仕事によって強いモデルがちがいました。 記事と広告文で、いちばん選ばれたモデルが別でした。
Claudeのモデル比較とは:暗算と筆算
Claudeには、軽い順に、Haiku(ハイク)、Sonnet(ソネット)、Opus(オーパス)、Fable(フェイブル)というモデルがあります。公式の案内では、Haikuは「最速・最低コスト」、Fableは「最高性能」と紹介されています。
もう1つ、「考える深さ」という設定があります。答える前に、どのくらい考えるかを決めるものです。
これは、暗算と筆算にたとえられます。問題を見てすぐ答えるのが暗算、紙に書いて確かめてから答えるのが筆算です。計算の得意な人でも、暗算ではまちがえます。今回の実験で分かったのは、この当たり前のことでした。
比べ方
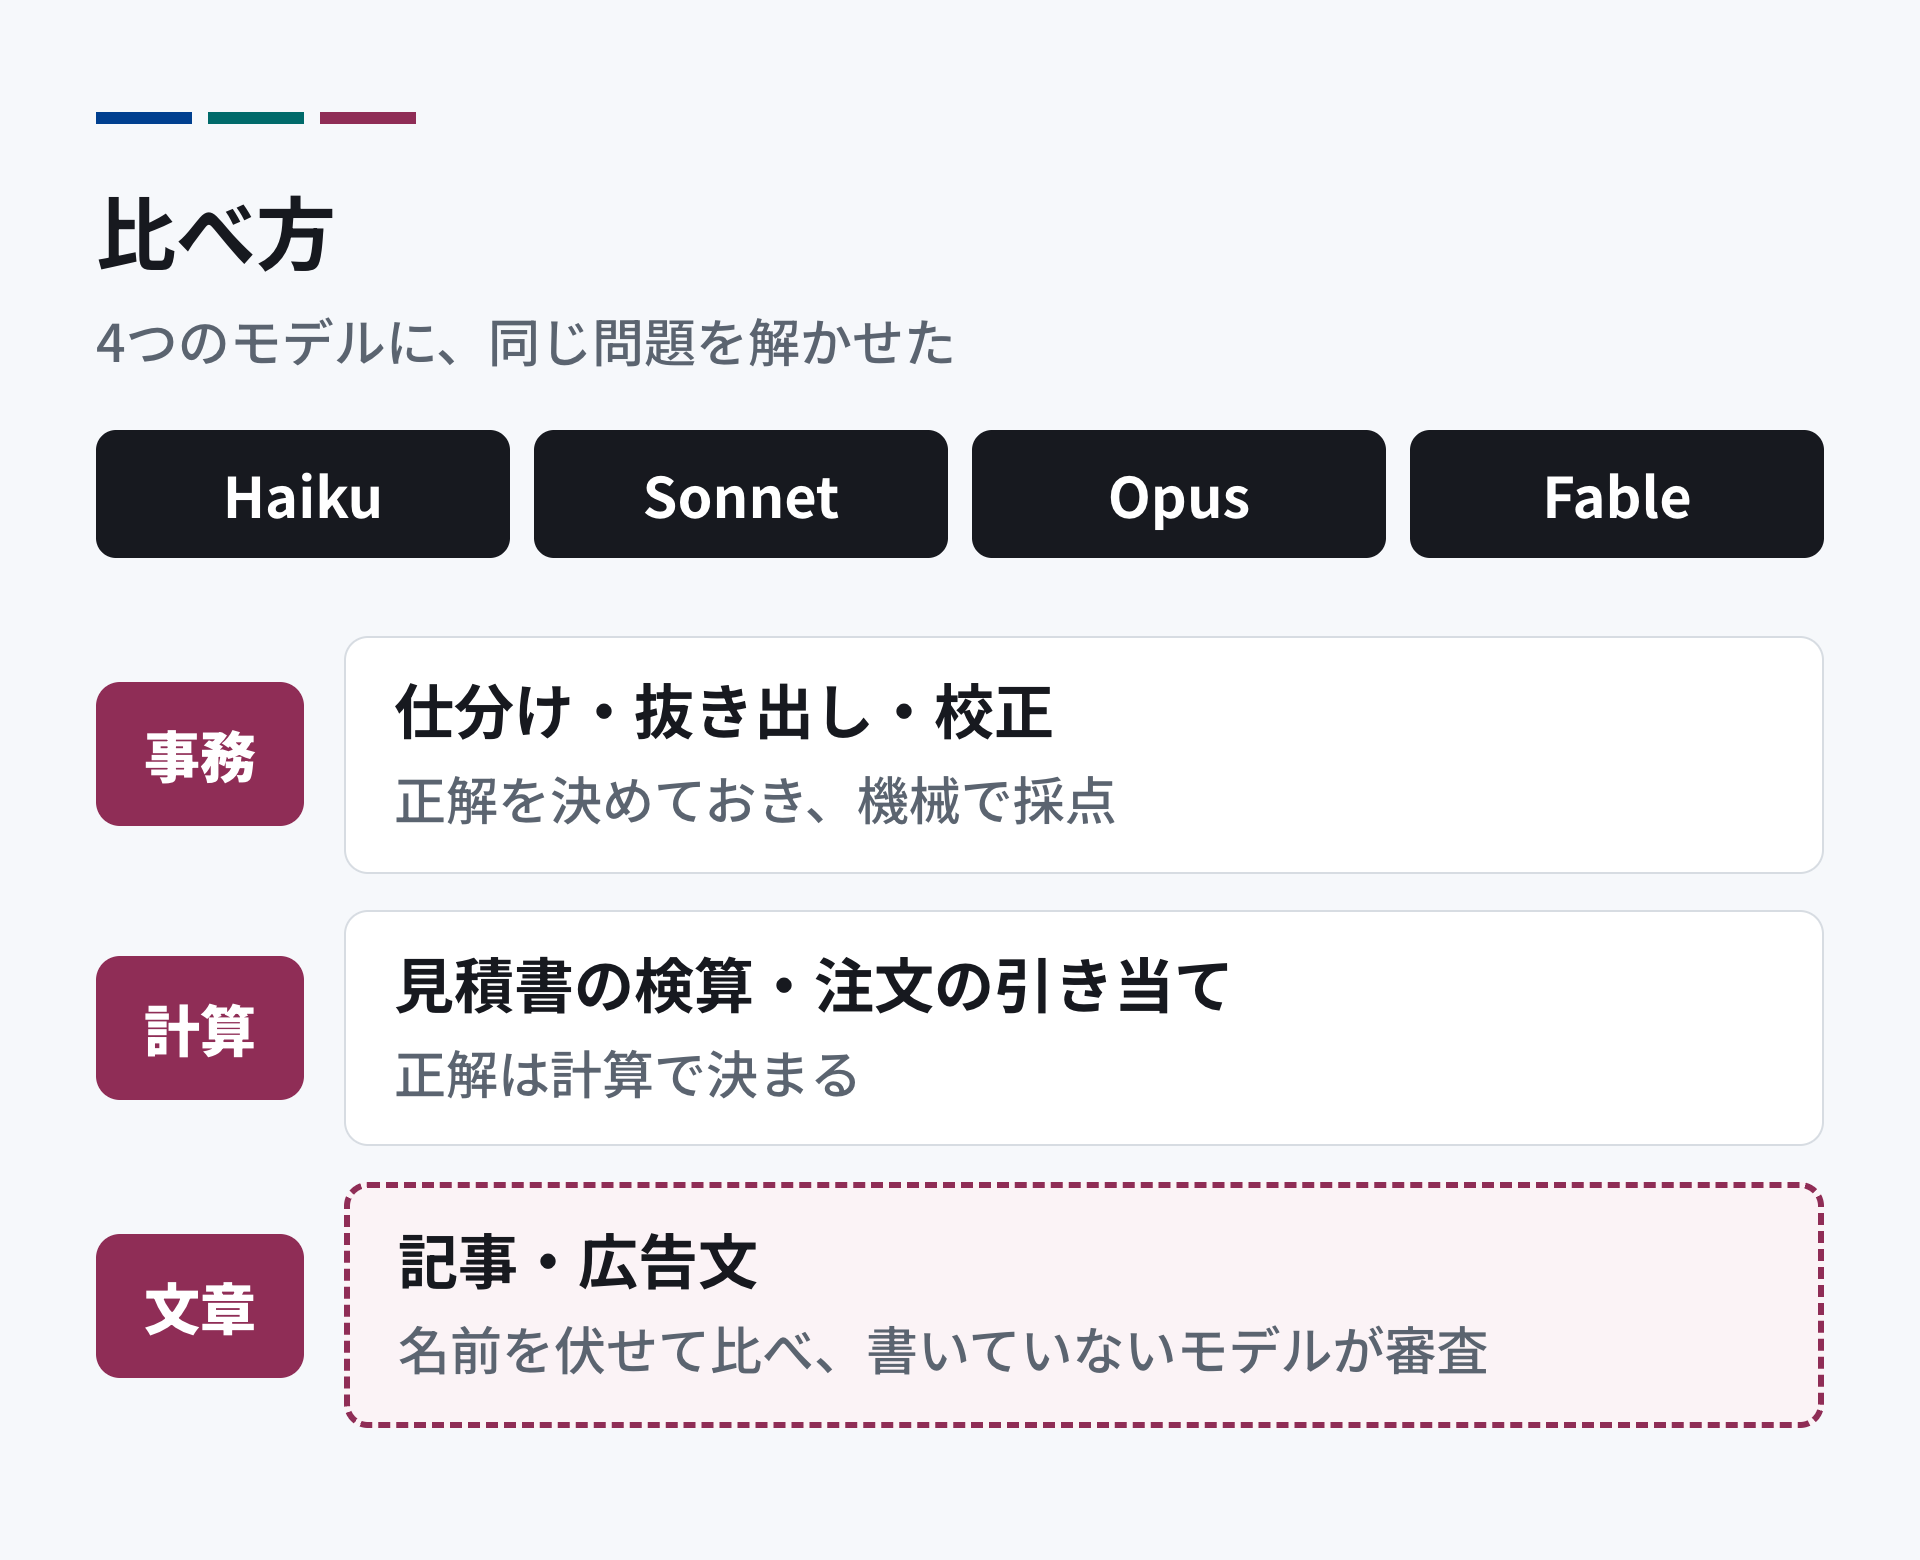
仕事を3種類用意し、4つのモデルに同じ問題を解かせました。
- 事務の仕事:問い合わせの仕分け、依頼メールからの項目の抜き出し、文章の校正。正解を決めておき、機械で採点しました。
- 計算の仕事:見積書の検算と、注文の引き当て。正解は計算で決まります。
- 文章の仕事:記事と広告文。名前を伏せて2つずつ比べ、審査は、その文章を書いていないモデルにさせました。
注文の引き当ては、たとえば次のような問題です。実際には、商品と注文がもっと多く並びます。
在庫:ネジ 10個
注文1:ネジ 6個
注文2:ネジ 6個
注文3:ネジ 4個
出せない注文は?
答えは注文2です。上から順に在庫を引いていかないと、解けません。
当社の実例:4つのモデルの結果
事務の仕事は、4つのモデルとも、正答率が9割台半ばから満点でした。差は、誤差の内です。費用は、いちばん軽いHaikuが、いちばん賢いFableの、50分の1から85分の1でした。
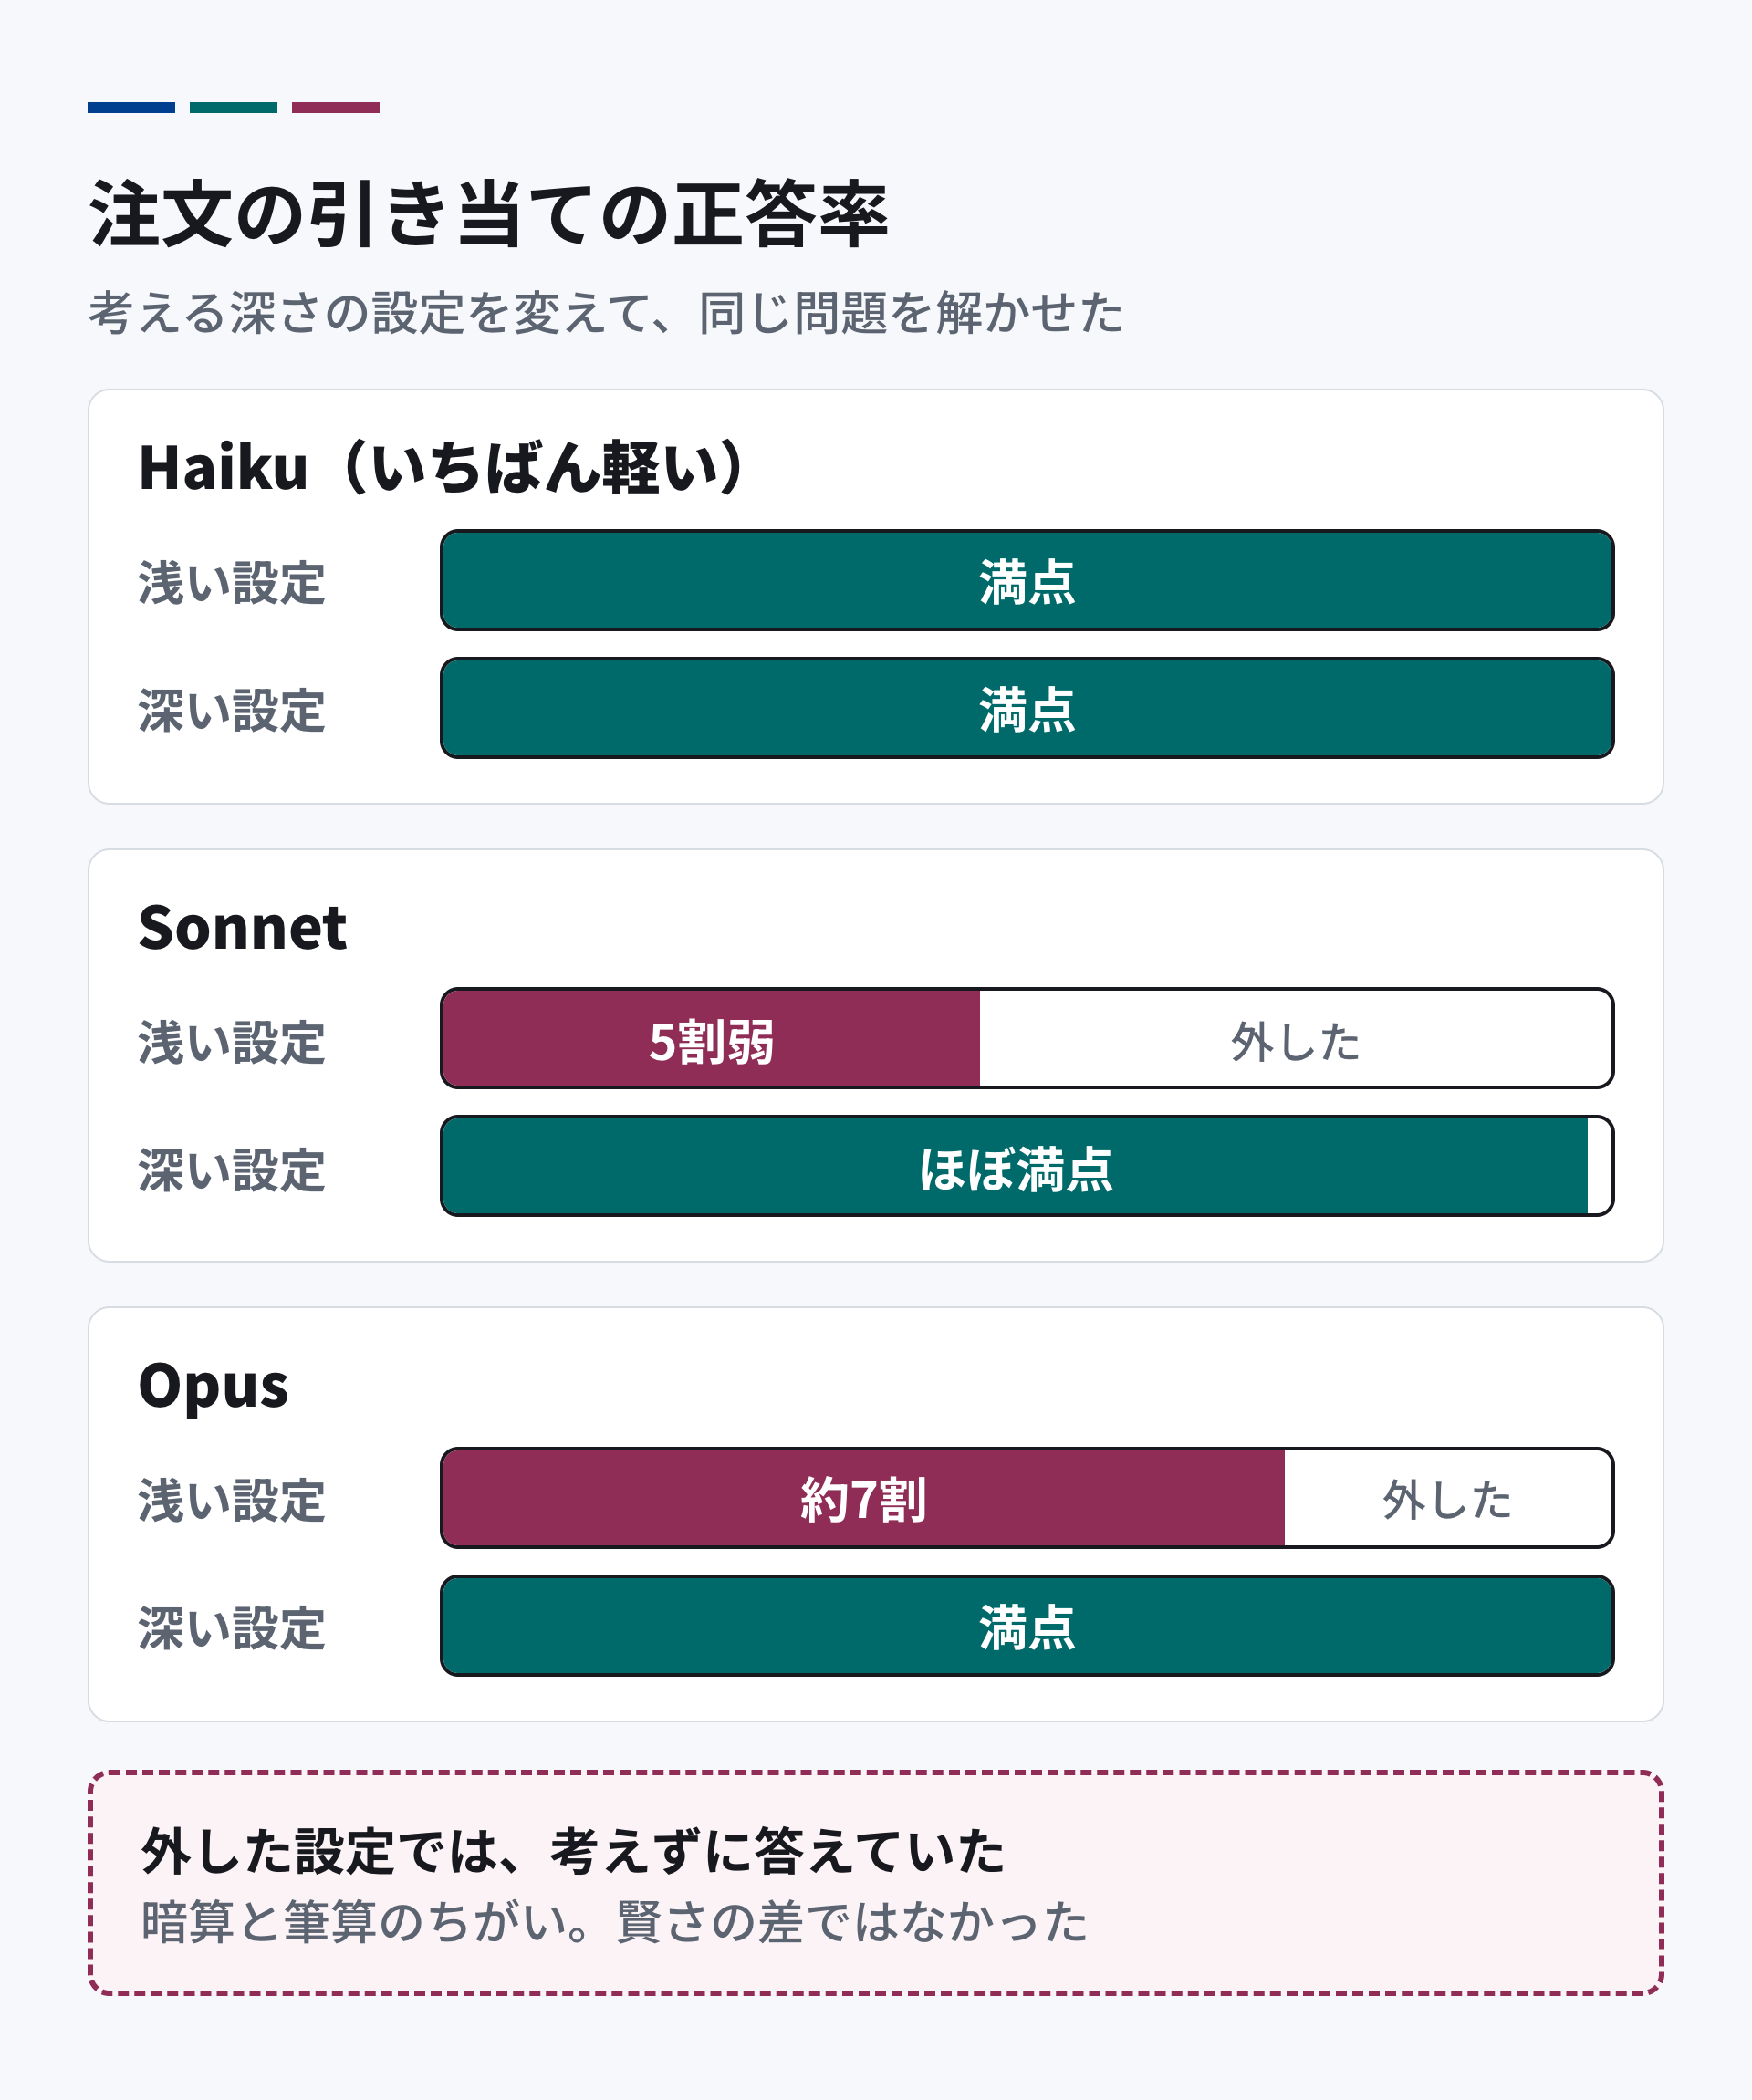
計算の仕事では、大きな差が出ました。注文の引き当ての正答率です。
| モデル | 浅い設定 | 深い設定 |
|---|---|---|
| Haiku | 満点 | 満点 |
| Sonnet | 5割弱 | ほぼ満点 |
| Opus | 約7割 | 満点 |
外した設定では、答える前に考えた量が、ほとんどありませんでした。暗算で答えていたのです。Haikuは、どの設定でも筆算をして、満点でした。Sonnetは「深い」にして初めて筆算をしました。Fableも「浅い」では約3分の2でした。同じ名前の設定でも、考える量はモデルによってちがいます。
文章の仕事は、結果が分かれました。記事では、Opusの下書きが、ほかのモデルとの比べの約4分の3で選ばれました。広告文では、Fableが8割強で選ばれました。Fableは、記事になると長く書きすぎて、決めた長さに収まったのは約4分の1でした。
記事を「深い」設定で書かせても、良くはなりませんでした。同じモデルの「中」の下書きのほうが、多く選ばれています。
使ってわかった注意
- 設定の名前を信じません。 「中」にしたから考えているだろう、とは言えませんでした。計算や、順番に処理する仕事を任せるときは、考えた跡があるかを確かめます。
- 比べる費用のほうが高くつきます。 AIに文章を審査させる費用は、文章を作らせる費用と同じくらいか、それ以上でした。何でも比べるのではなく、差が出そうな仕事にしぼります。
- 残高は、実際の数字で確かめます。 クレジットの期限は4日後でしたが、実験を並べて流したら、約1時間で9割以上を使いました。途中の見込みは、実際よりかなり少なく数えていました。
よくある質問
いちばん賢いモデルを選べば、まちがいないですか
そうとは言えませんでした。事務の仕事では差がなく、計算では、筆算をした軽いモデルが、暗算をした賢いモデルに勝ちました。先に軽いモデルで試し、足りない所だけ上げるほうが、費用に合います。
この結果は、ほかの会社の仕事にも当てはまりますか
そのままは当てはまりません。問題は当社がAIに作らせたもので、文章の良し悪しはAIどうしの審査です。人の目では確かめていません。記事の手引きも、Opusと一緒に作ってきたものなので、Opusに有利です。自社の仕事を少しだけ流して比べるのが、確かです。
まとめ
モデルは、賢さだけでは選べませんでした。事務は軽いモデル、計算は筆算をさせる、文章は仕事ごとに試す。これが、200ドルで分かったことです。
実験の前に立てた計画は、Claude APIの無料クレジットの使い道に書いています。開発の費用の考え方は、AIエージェント開発の費用相場で紹介しています。
当社では、どのモデルで足りるかの見きわめも含めて、AIを業務に組み込む開発を行っています。詳しくはAIエージェント開発・AI受託開発をご覧ください。
この記事の作り方
この記事の下書きと図は、AI(Claude Code)が作りました。数字は、当社が10月9日に行った実験の記録から出しています。問題づくりと実験もAIが行い、人は、内容の確認と公開の判断をしました。AIで書いた記事についての当社の考え方は、AIが書いた記事はGoogleに評価される?にまとめています。